CLAUDE’S PICK
free-for-dev — DevOps 엔지니어를 위한 무료 클라우드 서비스 모음
DevOps 및 인프라 엔지니어들이 적합한 무료 클라우드 서비스를 찾기 위해 많은 시간을 소비하는 문제를 해결하는 종합 리스트. SaaS, PaaS, IaaS 등 1600명 이상의 기여자가 만든 오픈소스 프로젝트로 시스템 관리자와 DevOps 전문가를 위한 실질적인 무료 티어 서비스들을 카테고리별로 정리하고 있다. 주요 클라우드 제공자의 상시 무료 한도부터 CI/CD, CDN, 모니터링, API 관리까지 DevOps 워크플로우 전체를 커버하는 서비스 모음을 제공한다.
핵심 포인트: 핵심 기여: 2000명 이상의 기여자, 139k 스타, 15k 포크를 기록하며 인프라 개발자 커뮤니티에서 가장 참고되는 무료 서비스 카탈로그로 자리잡았다.
🔗 github.com/ripienaar/free-for-dev
GitHub
TypeSafe AI — 구조화된 결정을 내리는 System One 모델 Jev 공개
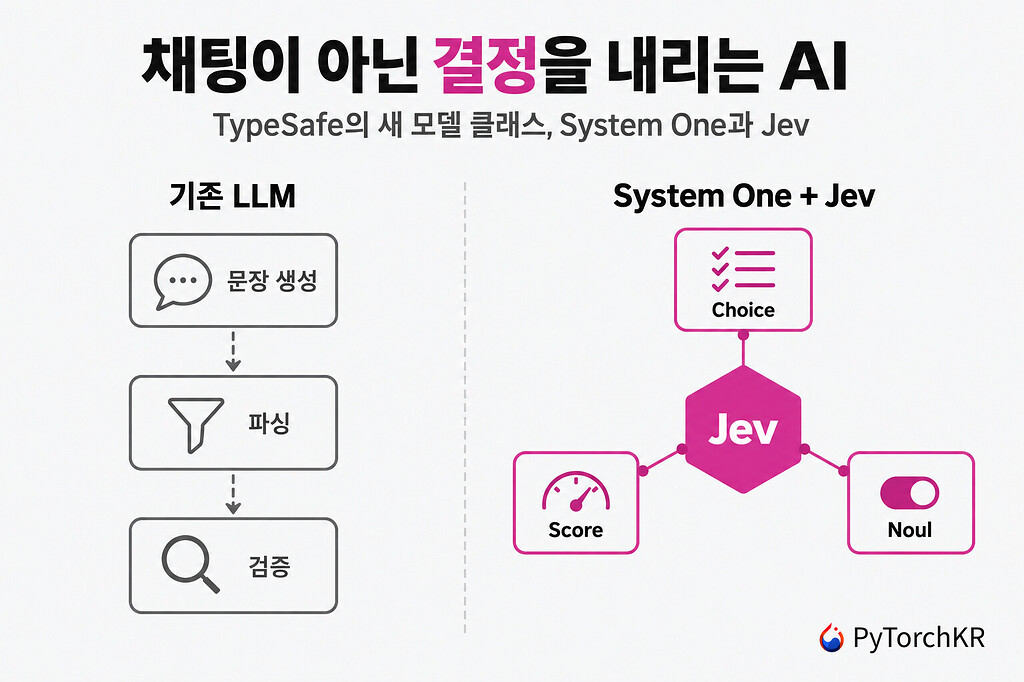
기존 LLM은 채팅에서는 뛰어나지만 소프트웨어 내 자동 판단 작업에서는 여전히 사람의 감독이 필요한 문제가 있다. TypeSafe AI는 이 간극을 해결하기 위해 새로운 모델 클래스인 System One을 개발했으며, 첫 공개 모델 Jev를 선보였다. Jev는 텍스트 생성이 아닌 구조화된 결정 출력에 최적화되어 기존 LLM 수준의 지능을 유지하면서도 속도와 효율성에서 수십 배 이상 우수하며, RLCD 훈련 기법으로 근본적으로 환각을 방지한다.
핵심 포인트: 핵심 성과: 기존 LLM과 동등한 지능 수준을 유지하면서 속도와 효율성에서 수십 배 이상 향상, 구조화된 확률적 결정 출력으로 완전히 환각 불가능한 신뢰성 달성.
🔗 discuss.pytorch.kr/t/jev-system-one-feat…
기타 (Others)
Claude Opus 5.5 — 40% 저렴한 비용으로 에이전트 코딩 성능 선도
LLM 기반 에이전트 작업과 복잡한 코딩 작업에서 성능이 필요하지만 비용 효율성도 중요한 문제가 있었다. Anthropic이 출시한 Claude Opus 5.5는 이전 Opus 5 대비 40% 저렴한 실행 비용으로 더 나은 성능을 제공한다. 680,000줄 코드 마이그레이션을 하루 만에 완료하고, 웹 앱 로드 타임 개선 작업에서 40회 중 39회 성공하는 등 복잡한 작업에서 대폭 향상된 능력을 보여준다. 또한 자동화된 행동 감사에서 역대 최고 점수를 기록하며 프롬프트 인젝션 저항성도 강화되었다.
핵심 포인트: 핵심 성과: 복잡한 코딩 작업에서 Opus 5 대비 우월한 성능(680K 라인 코드 1일 완성, 로드타임 개선 97.5% 성공률)을 유지하면서 실행 비용 40% 절감. 외부 평가자(Frontier, METR)와 자동화된 행동 감사에서 역대 최고 수준의 안전성 달성.
🔗 anthropic.com/claude-opus-5-5
기타 (Others)
AI & RESEARCH
LLaMA: 대규모 언어모델 기반 다단계 텍스트 검색 미세조정
기존 텍스트 검색 연구는 대규모 언어모델 출현 이전의 모델을 사용해왔다는 문제를 해결하기 위해, 본 연구는 최신 LLaMA 모델을 밀집 검색기RepLLaMA와 재순위 지정기RankLLaMA로 미세조정했다. MS MARCO 데이터셋을 활용한 종합적 실험을 통해 대규모 언어모델이 더 작은 모델을 능가하며, 긴 문맥을 자연스럽게 처리할 수 있어 기존의 문서 분할 및 풀링 전략이 불필요함을 입증했다.
핵심 포인트: 핵심 성과: RepLLaMA-RankLLaMA 파이프라인이 MS MARCO 벤치마크와 BEIR에서 강력한 성능을 발휘하며, 특히 영문서를 전체적으로 표현할 수 있어 기존 검색 방식의 한계를 극복했다.
논문 (Papers)
D-RAC: 엔터프라이즈 문서의 검색 최적화 청킹 기법
엔터프라이즈 지식베이스의 RAG 시스템에서 PDF, Word, 프레젠테이션 등 다양한 문서 형식을 수집할 때 기존 규칙 기반 추출과 OCR은 읽기 순서를 파괴하고 표 구조를 손실시키는 문제가 발생한다. D-RAC는 모든 입력 문서를 PDF로 정규화한 후 멀티모달 LLM을 통해 검색 최적화된 마크다운으로 변환하고, 가벼운 LLM 기반 청킹을 진행하여 높은 토큰 비용과 환각 위험을 제거한다.
핵심 포인트: 핵심 성과: 236개 문서 795페이지를 72분에 0 오류로 처리하여 1,748개의 검색 준비 청크 생성, 기존 아젠틱 청킹 대비 출력 토큰 95.7% 감소
논문 (Papers)
jev-reranker: 검색 결과의 92% 제거하며 관련성 필터링
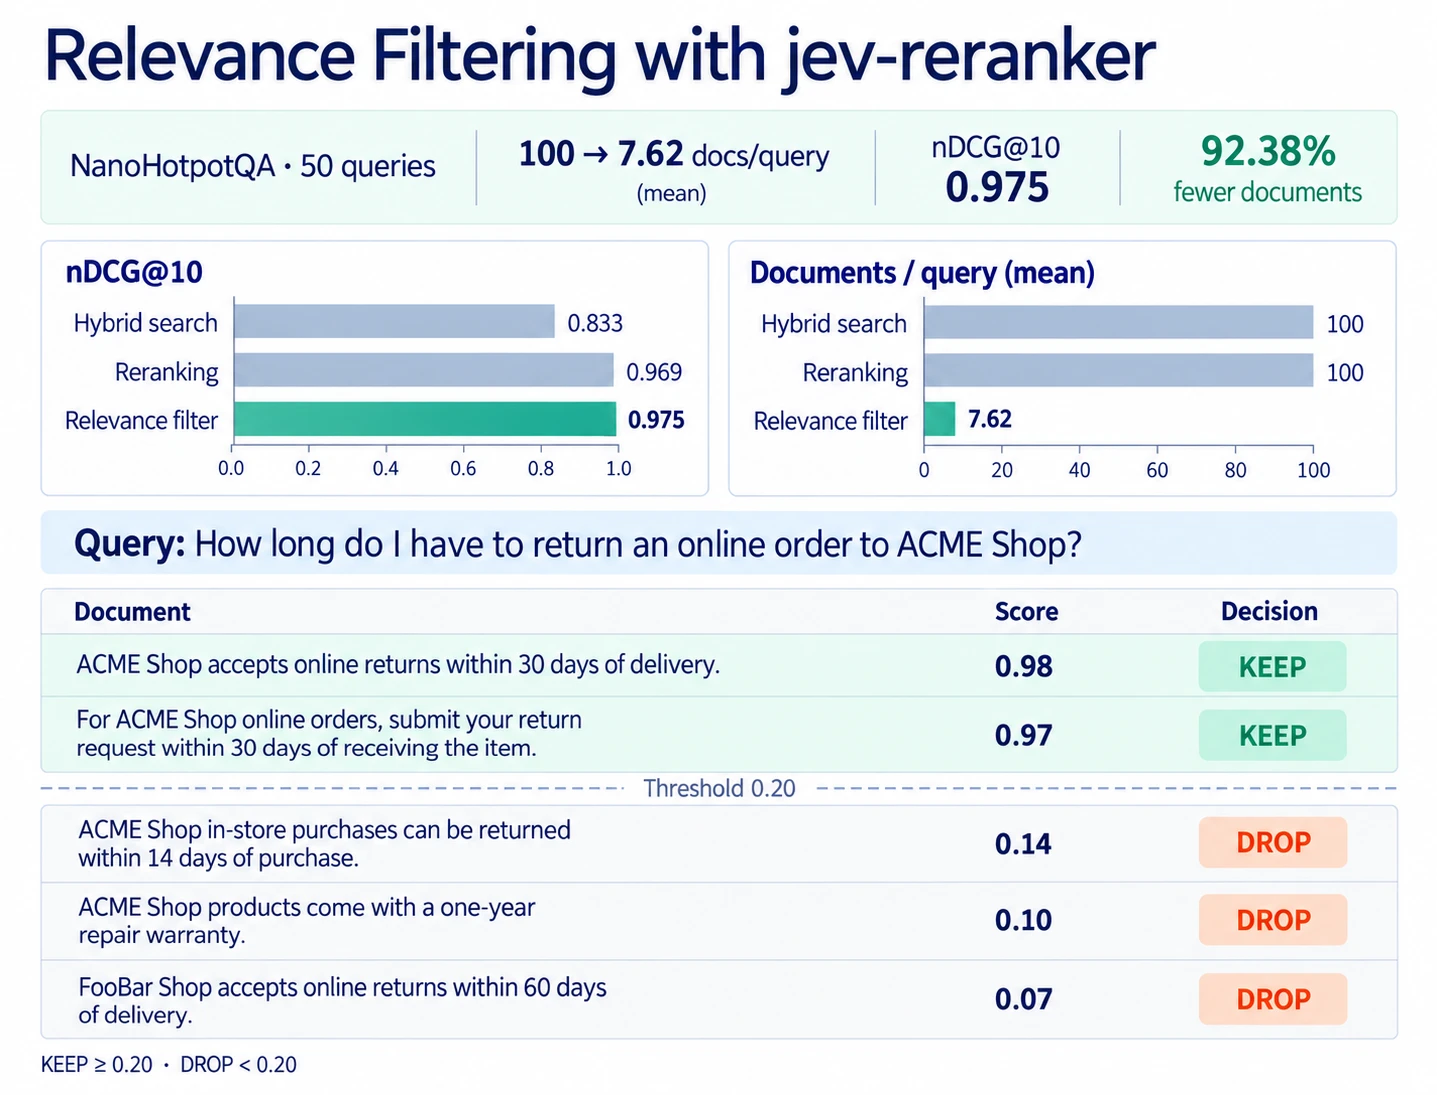
RAG 시스템에서 검색이 반환한 문서 중 실제로 유용하지 않은 것들이 많아 불필요한 토큰 소비와 LLM의 주의 산산을 야기하는 문제를 해결한다. jev-reranker는 관련성 필터링을 통해 NanoHotpotQA에서 후보 문서의 92.38%를 제거하면서도 nDCG@10 0.975의 높은 성능을 유지하며, 기존 하이브리드 검색이나 리랭킹 대비 효율적으로 쿼리당 평균 7.62개의 관련 문서만 남긴다.
핵심 포인트: 핵심 성과: 0.20 점수 임계값으로 평균 100개 문서를 7.62개로 압축하면서 기존 리랭킹(nDCG@10 0.969)을 능가하는 0.975의 정확도 달성 및 생성 단계 이전에 필터링 결정으로 불필요한 LLM 처리 제거.
🔗 huggingface.co/blog/hotchpotch/introducin…
기타 (Others)
Jev-Omni — 텍스트·이미지·음성·영상 처리하는 멀티모달 의사결정 모델
AI 에이전트의 빠른 판단 영역이 텍스트를 넘어 멀티모달 입력으로 확장되고 있다. 개발자 Akhila가 공개한 Jev-Omni는 Gemma 4 12B를 기반으로 텍스트, 이미지, 음성, 영상을 입력받아 선택지별 확률을 판단하는 의사결정 모델이다. H200 기준 텍스트 약 83ms, 이미지 26ms, 13초 음성 31ms의 초저지연 처리 성능을 제공하며 Apache 2.0으로 공개되었다.
핵심 포인트: 핵심 성과: H200 환경에서 텍스트 83ms, 이미지 26ms, 음성 31ms의 초저지연 멀티모달 처리로 AI 에이전트의 의사결정 영역을 텍스트에서 영상과 음성까지 확장
🔗 huggingface.co/akhilaaa3/Jev-Omni
기타 (Others)
Reranker 패러다임: 검색에서 의사결정으로의 확장
검색 시스템의 reranker는 query와 문서 점수를 통해 순서를 재정렬하는데, 이 동일한 인터페이스를 의사결정 영역에 적용할 수 있다. 현재 상황과 목표를 query로, 실행 가능한 행동을 문서로 치환하면 reranker의 점수 부여 메커니즘을 의사결정 시스템으로 활용할 수 있으며, 이는 검색 기술의 범용적 적용 가능성을 보여준다.
핵심 포인트: 핵심 기여: 검색 시스템의 reranker 아키텍처를 의사결정 문제로 일반화하여, 동일한 인터페이스로 컨텍스트 기반 행동 순위 결정을 실현한다.
🔗 linkedin.com/pulse/jev는-그냥-bert인가요-sigrid…
기타 (Others)
OpenTeams: LLM 검토자도 신뢰할 수 없는 이유
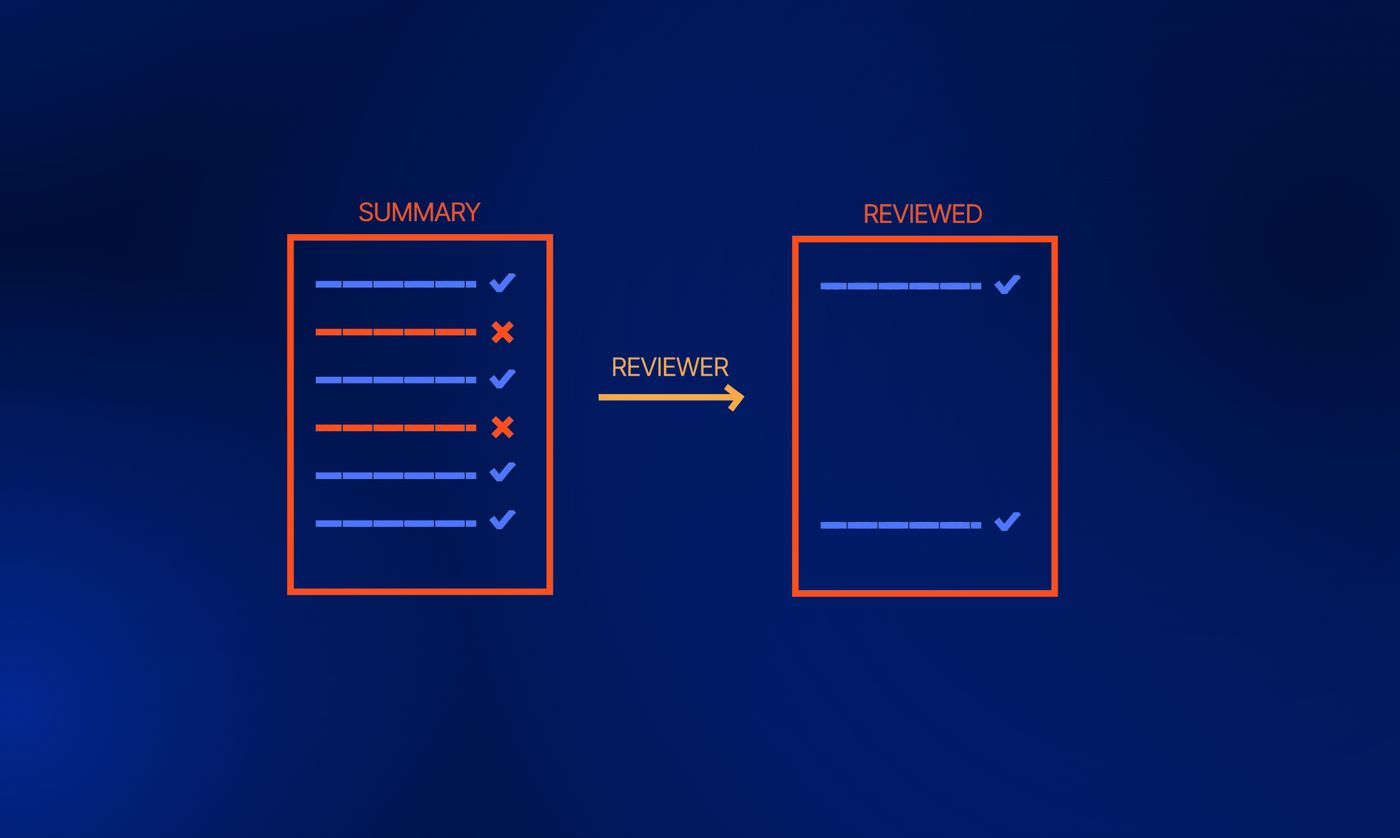
LLM이 작성한 요약문의 정확성을 검증하기 위해 다른 LLM을 검토자로 활용하는 방식의 한계를 실험으로 규명한 연구. 검토 모델들은 환각을 일부 포착했으나 사실인 내용까지 오삭제하는 문제가 발생했으며, 모델의 크기가 커도 검토 신뢰도가 비례하지 않았다. LLM 기반 검토 단계에서는 모델 자체보다 검토 파이프라인의 정교한 설계가 더 중요함을 시사한다.
핵심 포인트: 핵심 성과: qwen3:8b는 오류 12개 중 3개 포착, qwen2.5:14b는 6개, llama3.1:8b는 9개 포착했으나, 더 많은 오류를 잡은 모델도 정상 내용을 더 많이 삭제하는 역설적 결과 도출.
🔗 openteams.com/llm-review-reliability/
기타 (Others)
DiffusionGemma — 확산 모델을 활용한 Jev 스타일 고속 의사결정 모델
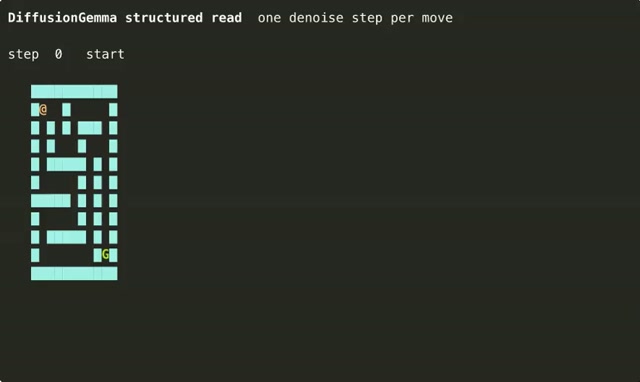
에이전트의 의사결정 속도를 높이기 위해 개발된 Jev 모델은 선택지만 확률로 반환해 0.1~0.5초 내 응답하지만, 기존 자동회귀 모델에는 적용이 어려웠다. 구글의 DiffusionGemma를 확산 모델 특성을 활용해 Jev 방식으로 구현한 vLLM 패치가 개발되었으며, 원본과 거의 동일한 정확도를 유지하면서 0.2초 내 결정을 내릴 수 있다. 확산 모델은 전체 캔버스를 한 번에 채우는 방식으로 여러 선택지를 동시 평가하고, 비전 능력까지 보유해 이미지 기반 의사결정도 가능하다.
핵심 포인트: 핵심 성과: DiffusionGemma 26B를 Jev 방식으로 운영 시 속도와 정확도가 원본 수준을 유지하며, DGX Spark 단일 장비에서 의사결정당 0.2초 처리, 비전 능력을 겸비한 소형 의사결정 전용 모델로 에이전트 인프라의 새로운 표준 제시.
🔗 github.com/vllm-project/vllm/pull/57250
GitHub
WeVisDoc-4B — 상업용 OCR 모델의 새로운 벤치마크
스캔 문서와 손글씨 인식 정확도가 낮은 기존 OCR 시스템의 한계를 극복하기 위해 텐센트가 개발한 WeVisDoc-4B 모델이 공개되었다. Apache 2.0 라이선스로 상업적 이용이 가능하며 OmniDocBench 벤치마크에서 95.38점을 기록해 우수한 성능을 입증했다. 문서 파싱과 RAG 파이프라인 구축 시 텍스트 추출 용도로 즉시 활용 가능한 수준의 정확도를 달성했다.
핵심 포인트: 핵심 성과: WeVisDoc-4B가 OmniDocBench v1.6 벤치마크에서 95.38점을 기록했으며, Apache 2.0 라이선스 기반으로 상업용 프로젝트에 자유롭게 적용 가능하다.
🔗 paperswithcode.co/benchmark/omnidocbench…
기타 (Others)
DiffusionGemma — 텍스트 디퓨전으로 에이전트 의사결정 병렬 처리
기존 LLM은 토큰을 순차적으로 생성하여 의사결정 시 비효율적이라는 문제를 해결하기 위해 Google Gemma가 DiffusionGemma 구조화 생성 모드를 제시했다. 양방향 Attention으로 전체 문맥과 여러 선택지를 동시에 평가하여 약 0.2초 내에 처리하며, 기존 Jev 방식과 유사한 판단 성능을 보인다. 이미지 포함 판단도 가능하고 Google Cloud Run에서 GPU 없이 쉽게 배포할 수 있어 에이전트의 수많은 작은 판단을 빠르고 저렴하게 처리할 수 있다.
핵심 포인트: 핵심 성과: DGX Spark에서 약 0.2초 처리, 동시 32개 요청 시 초당 약 100~123건 처리, GPU 사용 시간당 약 3.19달러로 비용 효율적
🔗 github.com/vllm-project/vllm/pull/57250
GitHub
Laya: 구조화된 결정을 위한 고속 비생성형 모델
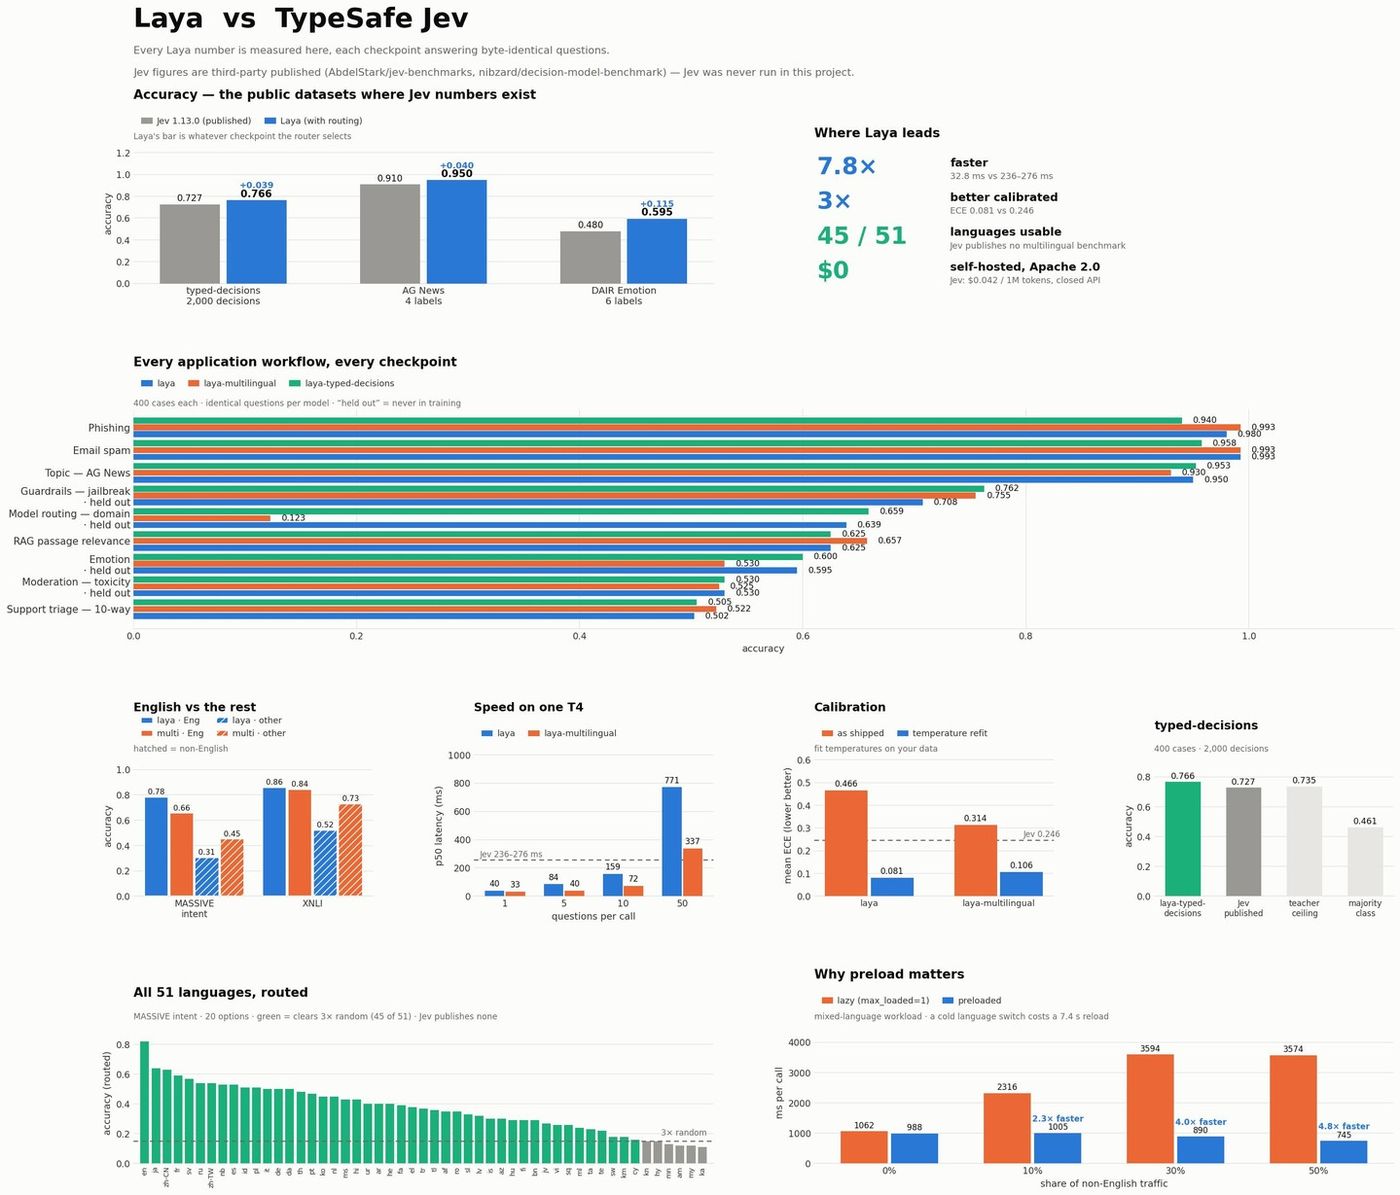
생성형 LLM의 느린 추론 속도와 구조화되지 않은 출력이 문제인 분류, 라우팅, 점수 예측 작업에서 Laya는 비자동회귀 아키텍처로 32.8ms의 초저지연 구조화 결정을 제공한다. 선택지, 점수, 불리언 확률 같은 제한된 출력 공간 설계로 후처리 부담을 제거하고, TypeSafe 같은 기존 방식 대비 7.8배에서 20배 빠른 성능을 달성하며 다국어 처리도 지원한다.
핵심 포인트: 핵심 성과: 단일 GPU 기준 P50 32.8ms, 배치 처리 시 질문당 7.2ms의 초저지연 구조화 결정 실현, 51개 언어 중 45개에서 무작위 기준 이상의 성능 달성.
🔗 threads.com/@punk.ai2/post/DdgL705j0UY?xm…
기타 (Others)
Jev — LLM 판정자 대체하는 저비용 고안정 에이전트 평가 모델
AI 에이전트 평가에서 LLM 판정자 방식은 비용이 높고 점수 변동성이 크다는 문제가 있다. TypeSafe AI의 Jev는 텍스트 생성 대신 구조화된 결정을 직접 반환하는 System One 모델로, 기존 Claude와 GPT 모델 대비 점수 변동성을 92~913배 낮추고 평가 비용을 28달러에서 0.34달러로 감소시킨다. 좁은 범위의 분류 및 라우팅 작업에 최적화된 새로운 평가 방식을 제시한다.
핵심 포인트: 핵심 성과: 점수 변동성 92~913배 감소, 평가 비용 0.34로 절감, 평균 처리 시간 0.44초로 Claude 대비 대폭 빠른 성능 달성.
🔗 langchain.com/blog/jev-agent-evals-langsm…
기타 (Others)
Jev — TypeSafe AI의 고속 의사결정 특화 프론티어 모델
기존 대형 언어 모델이 뛰어난 성능에도 불구하고 AGI로 이어지지 못하는 문제를 해결하기 위해 TypeSafe AI가 새로운 학습 방식 RLCD를 개발하고 Jev 모델을 출시했다. Jev는 기존 모델 대비 20-200배 빠르고 40-400배 저렴하며 의사결정 최적화에 특화되어 있으며, 브라우저 자동화와 결합할 경우 항공편 검색을 7초에 0.0039달러로 완료하는 등 실무 적용에서 극적인 비용 절감과 속도 향상을 실현한다.
핵심 포인트: 핵심 성과: 기존 모델 대비 20-200배 빠른 속도, 40-400배 저렴한 비용(출력 토큰 무료), 브라우저 자동화 작업 7초 완료 및 0.0039달러 처리 비용으로 실용적 AI 경제 혁명 구현
🔗 github.com/kraayenjon/awesome-jev
기타 (Others)
SPARSEUP: 희소 임베딩 모델의 새로운 기준
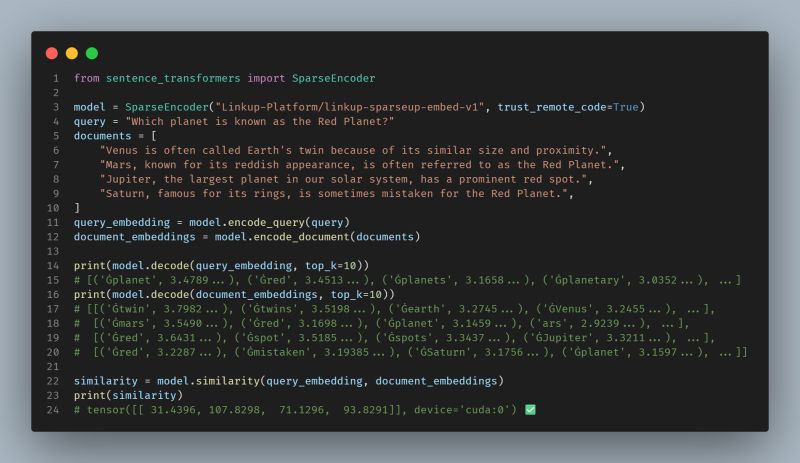
기존 희소 임베딩 모델들은 검색 성능과 속도 사이의 트레이드오프 문제를 겪고 있다. Linkup이 SPLADE 원저자 Thibault Formal과 함께 공개한 SPARSEUP은 BEIR-13에서 56.4 nDCG@10을 달성하며 동급 공개 모델들을 능가한다. 150M 파라미터 규모로 MS MARCO에서 밀리초 이하의 검색 지연시간을 제공하면서도 상용 라이선스(Apache 2.0)로 공개되어 있으며 Sentence Transformers와 완전히 호환된다.
핵심 포인트: 핵심 성과: BEIR-13에서 56.4 nDCG@10 달성으로 동급 규모 공개 모델 중 최고 성능 기록, MS MARCO에서 Seismic 인덱스와 결합 시 밀리초 이하의 검색 지연시간 실현.
🔗 linkedin.com/posts/tomaarsen_thibault-for…
기타 (Others)
MemoryArena — LLM 에이전트 메모리 벤치마크의 실전 성능 격차 분석
기존 LLM 에이전트 메모리 벤치마크는 과거 대화 회상이나 단일 세션 태스크만 측정하여 실전 성능을 반영하지 못하는 문제가 있다. MemoryArena는 다중 세션 장기 메모리가 필요한 4가지 실제 환경(웹 쇼핑, 여행 계획, 웹 검색, 수학 추론)을 통해 이 격차를 측정한다. 기존 LoCoMo에서 준최고 점수를 받던 에이전트들이 MemoryArena에서 평균 성공률 0.12~0.17로 급락하는 결과는 기억 회상과 실제 의사결정에 활용하는 능력이 별개임을 보여준다.
핵심 포인트: 핵심 성과: 기존 벤치마크에서 높은 점수의 에이전트들(GPT-5.1-mini 0.16, GPT-4.1-mini 0.12)이 다중 세션 복합 태스크에서 극적으로 성능 저하되며, 태스크당 평균 57개 액션 스텝과 40k+ 토큰 추적을 통해 메모리 기억과 활용의 본질적 차이를 규명했다.
🔗 jkf87.github.io/posts/2026-09-17-agent-me…
기타 (Others)
Jev — TypeSafe AI의 구조화된 초고속 의사결정 모델
기존 LLM은 문장을 토큰 단위로 생성한 후 결과를 파싱하고 검증해야 하는 비효율성이 있다. TypeSafe AI의 Jev는 처음부터 Choice, Score, Boolean, Confidence 같은 구조화된 답을 직접 반환하는 System One 모델로, 라우팅, 분류, 안전성 확인 등 반복되는 간단한 판단 작업에 최적화되어 있다. 기존 LLM 대비 최대 193.6배 빠르고 444.6배 저렴하며, 현재 Vercel AI Gateway에서 사용 가능하다.
핵심 포인트: 핵심 성과: 응답 속도 0.1초, 프론티어 LLM 대비 200분의 1 가격대로 구조화된 의사결정을 제공. AI 에이전트의 미래를 단일 대형 모델에서 역할 분담형 멀티모델 시스템으로 전환할 수 있는 기반 제시.
🔗 threads.com/@moment35film/post/DdZsFAdk-y…
기타 (Others)
Toss Benchmark — LLM 모델 평가를 위한 토스 맞춤형 벤치마크 구축
공개 리더보드의 높은 점수가 실제 서비스 성능을 보장하지 않는 문제를 해결하기 위해 토스는 자체 벤치마크를 구축했다. 금융, 커머스, 광고 등 다양한 도메인 업무에서 LLM의 실제 성능을 평가하며, 한국어 범용 성능과 토스 도메인 특화 성능을 함께 측정한다. 프롬프트 언어, 응답 속도, 도메인 지식 등이 모델 선택에 미치는 영향을 분석하여 Toss Foundation 모델 개발의 기준을 수립한다.
핵심 포인트: 핵심 기여: 한국어 평가에서 영어 리더보드 상위 모델과 순위 역전 현상을 발견하여 다국어 환경에서의 성능 평가의 중요성을 입증하고, 실제 업무 데이터 기반의 도메인 평가를 통해 범용 성능과 실무 성능의 격차를 정량화했다.
🔗 toss.tech/article/toss-benchmark
기타 (Others)
Dream-RSI — AI가 과거 시행착오를 재현해 자기개선하는 재귀적 탐색 프레임워크
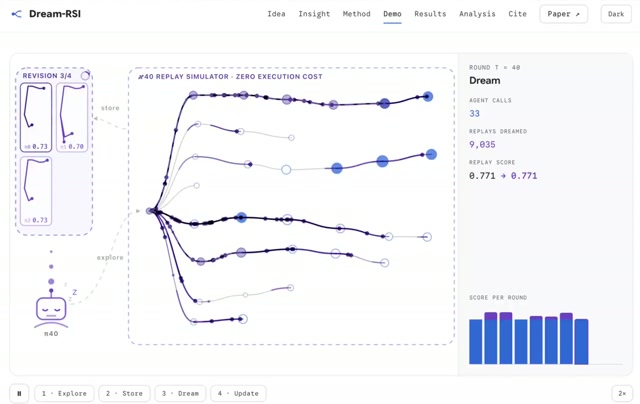
AI 에이전트가 복잡한 문제 해결 시 탐색 전략 개선에 막대한 비용이 드는 문제를 해결하는 프레임워크. 과거 탐색 기록을 Discovery Tree로 저장하고, 이를 정확한 시뮬레이터로 활용해 새로운 탐색 정책을 실제 실행 없이 재현 테스트한다. 이를 통해 비싼 평가 비용 없이 수천 개의 탐색 전략 후보를 검증하고, 최적 전략만 배포하는 방식으로 탐색 성능을 재귀적으로 개선한다.
핵심 포인트: 핵심 기여: 과거 탐색 기록을 정확한 시뮬레이터로 재활용해 새로운 탐색 정책을 제로 실행 비용으로 테스트하며, 각 개선 사이클마다 새로운 Discovery Tree를 축적해 더 복잡한 문제 공간 탐색 가능.
기타 (Others)
Jev Ultrafast — 7초 만에 항공편 검색하는 초고속 브라우저 에이전트
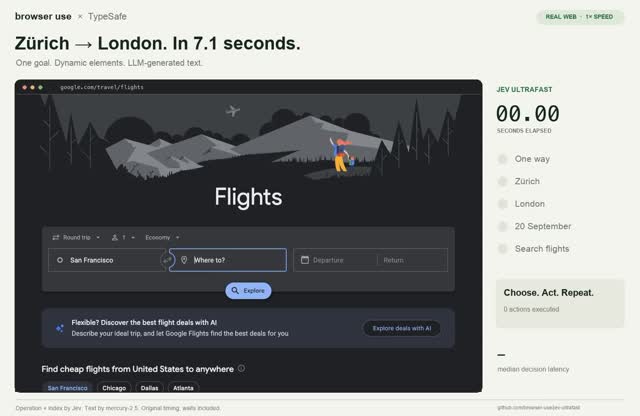
기존 브라우저 에이전트의 느린 응답 속도 문제를 해결하기 위해 동적 인덱싱 액션 스페이스를 활용한 경량 LLM 기반 에이전트. 자연어 목표 입력 시 요소 선택과 작업 결정을 동시에 수행하며, 텍스트 입력이 필요한 경우에만 생성을 실행한다. Zürich에서 London 항공편 검색을 7.1초 내에 완료하면서 비용은 0.0039달러에 불과하다.
핵심 포인트: 핵심 성과: 구글 플라이츠 항공편 검색을 7.1초 내 완료하며 토큰 기반 비용을 최소화, GitHub 레포 24시간 내 1.3k 스타 달성으로 초고속 브라우저 유즈 기술 검증
🔗 github.com/browser-use/jev-ultrafast
GitHub
CoSQ — 신뢰도 점검 기반 LLM 환각 감소 프롬프트 프레임워크
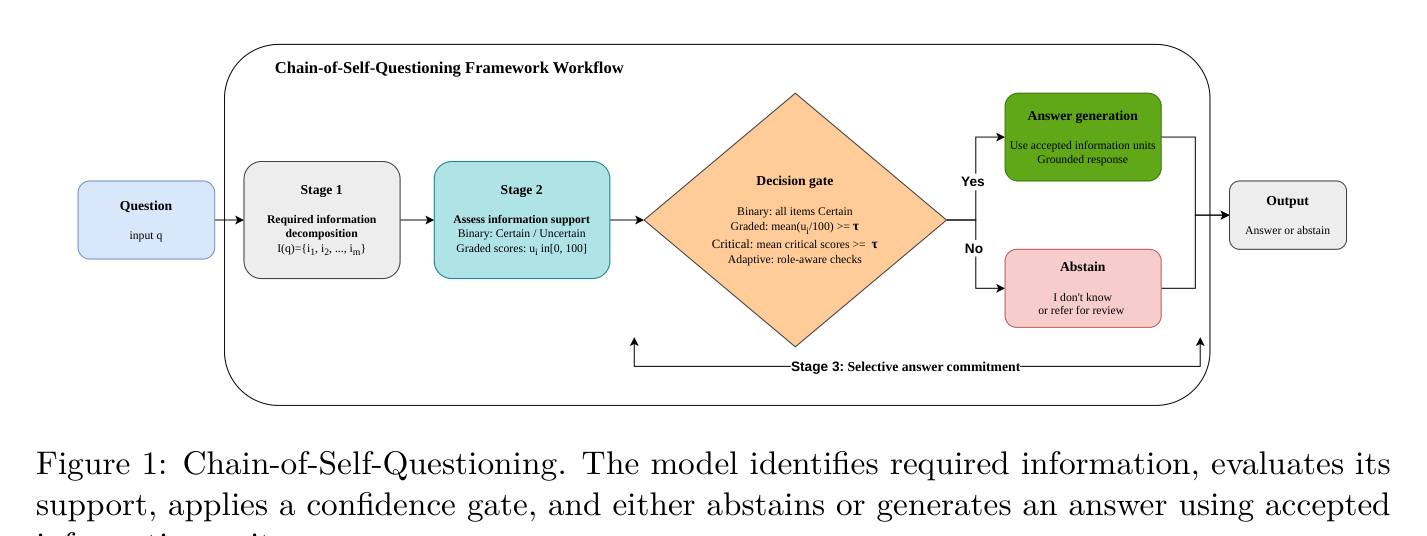
LLM이 근거 없이 유창하게 거짓 답변을 생성하는 문제를 해결하는 프롬프트 전용 프레임워크. 질문에 필요한 정보 단위를 나열하고 신뢰도 점수를 매긴 후 임계값을 초과할 때만 답변하고 그렇지 않으면 기권하는 3단계 방식으로 작동한다. 파인튜닝 없이 프롬프트만으로 구현 가능하며, TruthfulQA 데이터셋에서 오답 커밋률을 32.1% 감소시키면서 동시에 정답률을 향상시킨다.
핵심 포인트: 핵심 성과: 11개 모델 전체에서 TruthfulQA 817문항 대상 CoT 대비 오답 커밋률 13.1%에서 8.9%로 감소(32.1% 상대 감소), 정답률 86.9%에서 89.7%로 동시 개선. 기권한 문항의 31.3%는 원래 틀렸을 문제에서의 옳은 기권으로 효율적 리스크 관리 실현.
🔗 threads.com/@conanssam/post/DdXVB7xkwjE?x…
기타 (Others)
Quasar 1.1 438B — 양자 컴퓨터 데이터로 학습한 AI 모델
기존 AI 모델 학습에서 고전 컴퓨터 데이터만 활용하던 한계를 극복하기 위해 Multiverse Computing이 양자 컴퓨터 생성 데이터를 학습 파이프라인에 통합했다. IBM의 156큐비트 Heron 프로세서로 생성한 데이터를 CompactifAI 파이프라인에 포함시켜 GLM-5.2 기반 Quasar 1.1 438B를 개발했으며, 양자 영감 전문가 선택 기법으로 각 계층의 전문가를 256개에서 148개로 축소해 모델 크기와 추론 비용을 동시에 줄였다.
핵심 포인트: 핵심 성과: 양자 컴퓨터 생성 데이터가 AI 모델 학습 파이프라인에 처음 통합되었으며, 양자 영감 전문가 선택으로 각 계층 전문가 수를 42% 감소시켜 모델 효율화 실현
🔗 multiversecomputing.com/resources/quasar…
기타 (Others)
Amazon AGI — RAG 대신 KV 캐시에 문서 저장하는 Cartridges 기법
RAG(검색 증강 생성)는 외부 문서 검색에 따른 지연과 비용 문제가 있다. Amazon AGI 팀은 문서를 모델의 KV 캐시에 직접 저장하는 Cartridges 기법을 제안하고, 컨텍스트 윈도우, KV 캐시, 모델 파라미터 세 가지 저장 위치를 5개 벤치마크에서 비교했다. 결과적으로 Cartridges는 고압축 환경에서 우수한 성능을 유지하지만 치명적 망각 현상이 발생하며, 이는 파라미터 수가 아닌 풀랭크 업데이트로 인한 것으로 분석된다.
핵심 포인트: 핵심 성과: Cartridges는 20배 압축 시에도 성능이 평탄하게 유지되는 반면 Compaction은 FinQA 66.4→19.3으로 급락하나, HumanEval에서 16점 하락하는 치명적 망각 현상이 발생한다.
🔗 conanssam.com/posts/2026-09-17-rag-vs-car…
기타 (Others)
DEVTOOLS & OPEN SOURCE
Fast Jev Compaction — 코딩 에이전트 컨텍스트 정리 시 요약 대신 삭제로 정보 손실 방지
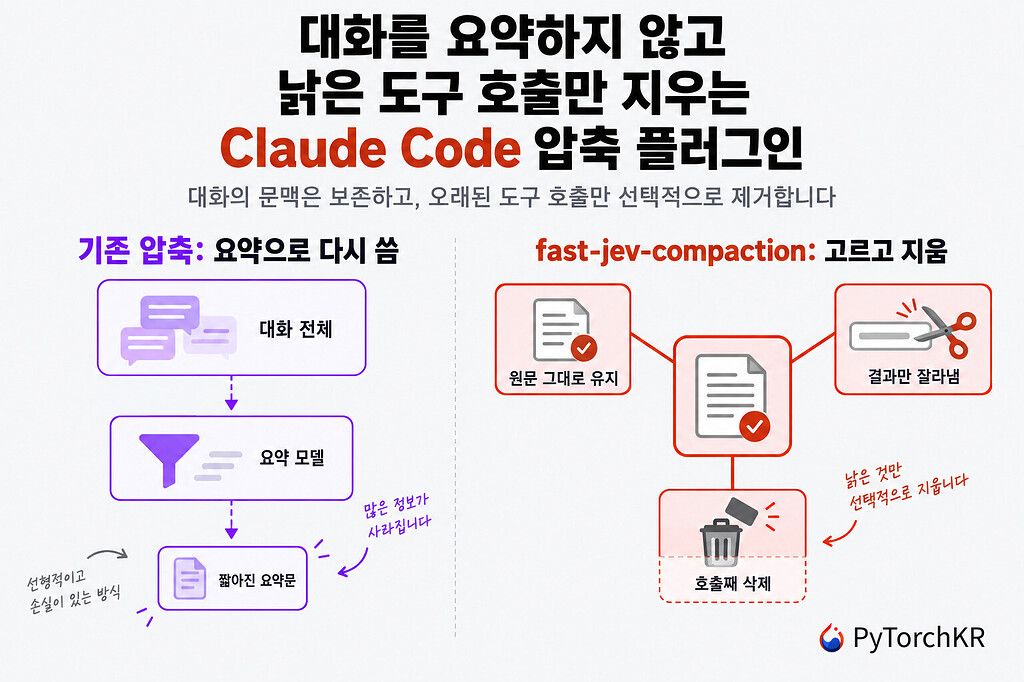
장시간 코딩 에이전트와 상호작용하면 대화 내용이 컨텍스트 창을 채우는데, 기존 도구들은 오래된 대화를 요약하면서 파일 경로, 오류 메시지, 제약사항 등 중요 정보가 손실되는 문제가 발생한다. Fast Jev Compaction은 요약 단계를 건너뛰고 불필요한 도구 호출 결과만 선별적으로 삭제하는 Claude Code 플러그인이다. TypeSafe AI의 Jev 모델을 활용해 각 도구 호출의 기록 필요 여부와 원문 유지 필요 여부를 확률적으로 판단하여 정보 손실을 최소화한다.
핵심 포인트: 핵심 기여: 요약 기반 컨텍스트 압축의 정보 손실 문제를 해결하고, 필요한 도구 기록만 선별 삭제함으로써 에이전트가 중요 세부사항을 유지한 채 장기 세션을 효율적으로 관리 가능하게 함.
🔗 discuss.pytorch.kr/t/fast-jev-compaction…
기타 (Others)
classifier.dev — Jev 대비 90% 정확도의 무료 오픈소스 분류 모델
LLM 기반 빠른 의사결정 모델 Jev 출시 직후 더 높은 성능을 주장하는 오픈소스 대안이 등장했다. Michael이 공개한 classifier.dev는 여러 선택지 중에서 입력 내용을 분류해 결과를 반환하는 서비스로, 무료이며 코드도 오픈소스로 공개되어 있다. 단일 Cloudflare Worker로 구동되며 API 키나 회원가입 없이 사용 가능하고, 향후 이미지 지원과 종단간 암호화 엔드포인트 추가를 계획하고 있다.
핵심 포인트: 핵심 성과: 일부 작업에서 약 90% 정확도를 기록하며 Jev보다 높은 성능 달성, 무료 오픈소스로 제공되며 의존성 없는 단순한 아키텍처로 구현됨
🔗 github.com/mrmps/classifier-dev
GitHub
Bespoke-Nimble-9B — Jev의 오픈소스 경량 결정 모델
LLM 기반 결정 모델 Jev가 공개된 이후 유사한 오픈소스 대안들이 빠르게 등장하고 있다. Bespoke Labs는 Qwen3.5-9B를 미세 조정한 Bespoke-Nimble-9B를 공개했는데, 이는 문장 생성 없이 주어진 선택지의 확률을 직접 계산하여 타입 안전 결정을 내린다. 공개 벤치마크에서 정확도는 Jev 77.3%에 비해 75.9%로 소폭 낮지만, H100에서의 응답 시간은 106ms로 Jev API의 246.7ms보다 2배 이상 빠르다. 모델, 학습 데이터, 학습 방법을 모두 공개하며 로컬 실행을 지원한다.
핵심 포인트: 핵심 성과: H100에서 106ms 응답 시간으로 Jev API 대비 2.3배 고속화, 3,880개 라벨 데이터와 324개 합성 평가 벤치마크 공개, Apple Silicon과 NVIDIA GPU 로컬 실행 지원
🔗 github.com/bespokelabsai/nimble
GitHub
MemOS — LLM 에이전트를 위한 통합 메모리 관리 프레임워크
LLM 기반 에이전트가 대화 중단 시 기억을 완전히 잃는 문제를 해결하는 오픈소스 메모리 운영 체제. 텍스트, 이미지, 도구 실행 흔적, 페르소나를 단일 API로 통합 관리하며, MemScheduler를 통해 밀리초 단위 비동기 수집과 색인을 지원한다. 벤치마크에서 토큰 사용량 35.24% 감소, LoCoMo 88.83점, 에이전트 작업 완료율 36.63%에서 50.87%로 향상을 입증했다.
핵심 포인트: 핵심 성과: 토큰 사용량 35.24% 감소, LoCoMo 88.83점/LongMemEval 89.20점 달성, OpenClaw 통합 시 에이전트 작업 완료율 14.24%p 상승. 자연어 피드백 루프로 저장된 기억을 벡터DB 재삽입 없이 즉시 교정 가능.
GitHub
ENGINEERING
Agent Substrate — AI 에이전트 전용 고속 실행 런타임
AI 에이전트는 LLM 응답 대기 중에도 전체 컨테이너 리소스를 점유하는 문제가 있다. Agent Substrate는 유휴 에이전트의 메모리와 파일시스템을 스냅샷으로 저장했다가 요청 시 0.5초 이내에 복구하는 방식으로 이를 해결한다. 파드 8개로 250개 세션을 처리하는 30배 과적재를 달성하며, 초당 500회 이상의 재우기/깨우기 작업을 gVisor와 마이크로VM 격리와 함께 지원한다.
핵심 포인트: 핵심 성과: 파드당 에이전트 밀도 30배 증대, 0.5초 이내 복구 속도, 초당 500회 이상 suspend/resume 처리, 기본 제공되는 제로트러스트 커널 및 네트워크 격리
🔗 github.com/agent-substrate/substrate
GitHub
PRODUCT & INDUSTRY
GPT-6 Sol and Luna — 비용 효율성을 갖춘 고성능 AI 모델 공개
OpenAI가 GPT-6 Astra 이후 GPT-6 Sol과 Luna를 출시하여 고급 AI 기능을 더 저렴한 비용으로 제공한다. 이 두 모델은 Astra와 동일한 훈련 방식으로 개발되어 전문 작업, 코딩, 컴퓨터 사용 및 정렬 성능을 보유하면서도 추론 최적화와 캐싱 개선을 통해 API 가격을 50% 인하했다. 복잡한 작업을 수행하면서도 더 높은 사용 한도와 낮은 비용으로 반복 작업이 가능하여 일상적인 작업과 대규모 애플리케이션에 고급 AI를 실용화한다.
핵심 포인트: 핵심 성과: GPT-6 Sol과 Luna는 이전 GPT-5.6 모델 대비 API 가격을 50% 인하(Sol 4달러에서 20달러, Luna 0.20달러에서 1.20달러 per 1M tokens)하면서 Astra의 지능 수준을 유지한 비용-지능 곡선의 새로운 기준을 제시한다.
🔗 openai.com/index/introducing-gpt-6-sol-an…
기타 (Others)
건축 AI: 렌더링 도구에서 설계 의사결정 에이전트로
건축 설계 프로세스에서 AI의 역할이 시각화 도구를 넘어 확장되고 있다. 최근 출시되는 건축 AI 제품들은 설계 데이터 연결, 사업성 분석, 착공 전 리스크 검토 등 의사결정 전 단계를 지원한다. Autodesk Forma의 차세대 Assistant는 구조 변경의 공정과 비용 영향을 프로젝트 맥락에서 분석하고, TestFit은 MCP 연결로 부지 배치와 사업성을 동적으로 계산하며, Document Crunch는 계약서와 시방서 간 공사 범위 누락을 자동 감지한다.
핵심 포인트: 핵심 기여: 건축 AI의 질문이 뭘 그릴까에서 이걸 바꾸면 어디까지 영향이 갈까로 전환되며, 설계안별 사업성 계산과 문서 간 리스크 자동 검출을 통해 설계부터 착공까지 전주기 의사결정을 지원한다.
🔗 threads.com/@alex_opencrab.sh/post/Ddc9G…
기타 (Others)
Typeform — AI 기반 양식 자동화로 고객 발굴 및 리드 육성 자동화
기업들은 수집된 데이터 속에서 미래 고객을 찾기 어려운 문제를 겪고 있다. Typeform AI는 자동화된 워크플로우를 통해 응답자를 연락처 목록으로 자동 분류하고, 추적 이메일과 SMS로 리드를 자동 육성하며, 회사와 고객 정보를 기억하여 관련성 높은 양식과 워크플로우를 생성한다. 이를 통해 반복적인 작업을 제거하고 프로세스를 단순화한다.
핵심 포인트: 핵심 성과: 자동화된 양식 생성과 지능형 리드 육성으로 응답자 관리 효율성 극대화, 기업 컨텍스트 기억 기능으로 개인화된 고객 참여 실현
🔗 typeform.com/ai?utm_campaign=SP0ZZxLc&…
기타 (Others)